Компания Gorgona AI посчитала, во что обходится узбекский язык у пяти крупных провайдеров ИИ. Один и тот же текст на узбекском занимает в 1,55−2,17 раза больше токенов, чем на английском, а две модели с одинаковым прайсом выставляют за него счета, которые различаются в 1,7 раза.
Счет, которого не было в плане
При запуске чат-бота поддержки для узбекоязычных клиентов компания выбрала модель, ориентируясь на стоимость миллиона токенов, рассчитала предполагаемый объем диалогов и протестировала прототип на английском языке. Однако уже через месяц фактический счет оказался почти вдвое выше запланированного.
В расчетах нет ошибки, ошибка в допущении. Цена за токен одинакова для всех языков, а вот число токенов на один и тот же смысл разное. И узбекскому здесь не везет.
Как ИИ «читает» узбекский
Языковые модели читают текст не словами, а токенами, фрагментами, на которые его режет токенизатор. Английское слово обычно занимает один токен: английского больше всего в данных, на которых обучали модели. Слово на языке, который встречался там реже, распадается на несколько кусков, и за каждый приходится платить.
Узбекский агглютинативный: слово собирается из корня и цепочки аффиксов. Kitoblarimizdan («из наших книг») передает смысл трех английских слов. Если словарь модели не знает этих частей, токенизатор режет слово по частоте, а не по смыслу.
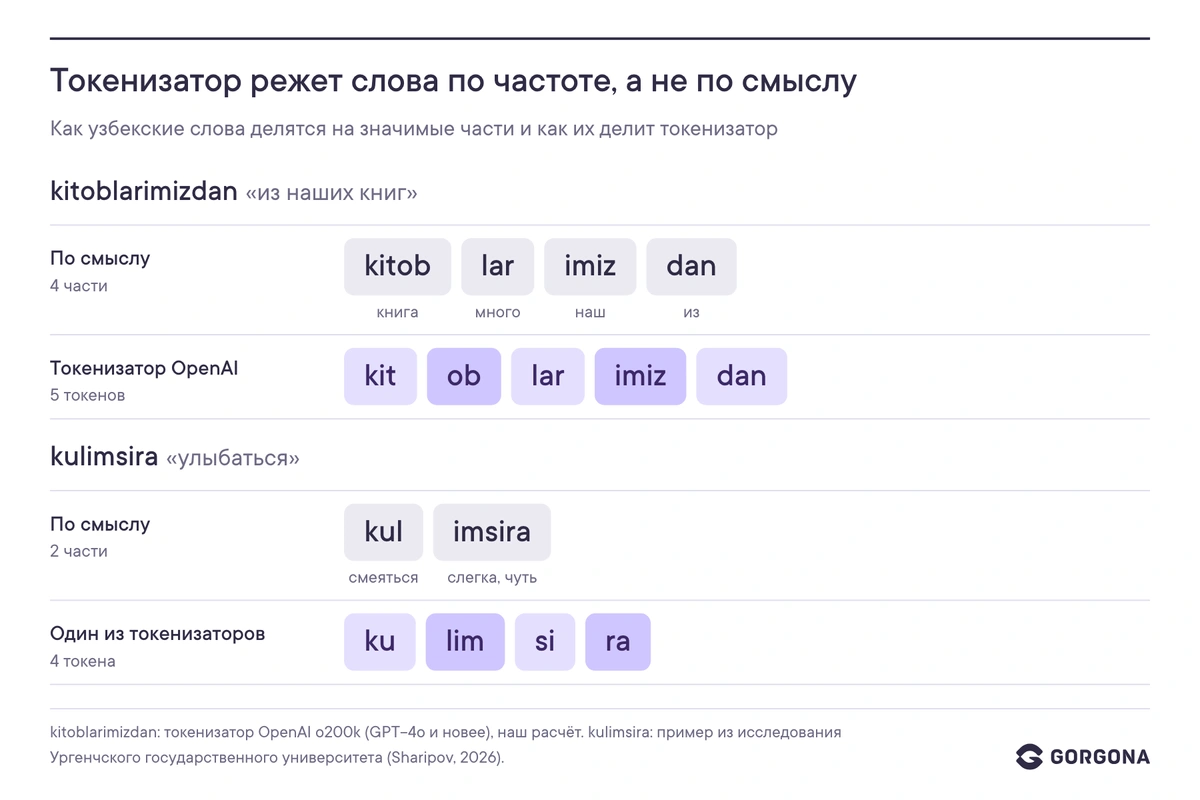
Токенизатор OpenAI делит kitoblarimizdan на пять токенов, хотя значимых частей в слове четыре. Глагол kulimsira («улыбаться») в одном из токенизаторов распадается на ku, lim, si и ra, и от корня kul («смеяться») ничего не остается.
Что показал замер
С 2023 года, когда модели стали платными сервисами с оплатой за токен, у этого эффекта есть название: «налог на токены». Но для узбекского его мерили на небольших выборках и открытых токенизаторах, без Claude, Gemini и последних версий Qwen и DeepSeek. Сколько это стоит в долларах, никто не считал.
Gorgona AI проверила 1337 параллельных текстов через 15 токенизаторов, от крупных провайдеров до открытых моделей. Для Claude и Gemini токены считали официальными методами провайдеров, как их считает биллинг, а выводы проверили на реальных ответах моделей: почти 8 тыс. запросов. При этом авторы исследования отмечают, что качество ответов не проверялось. Эксперты Gorgona AI говорят, что этот показатель может стать следующим аспектом для изучения.
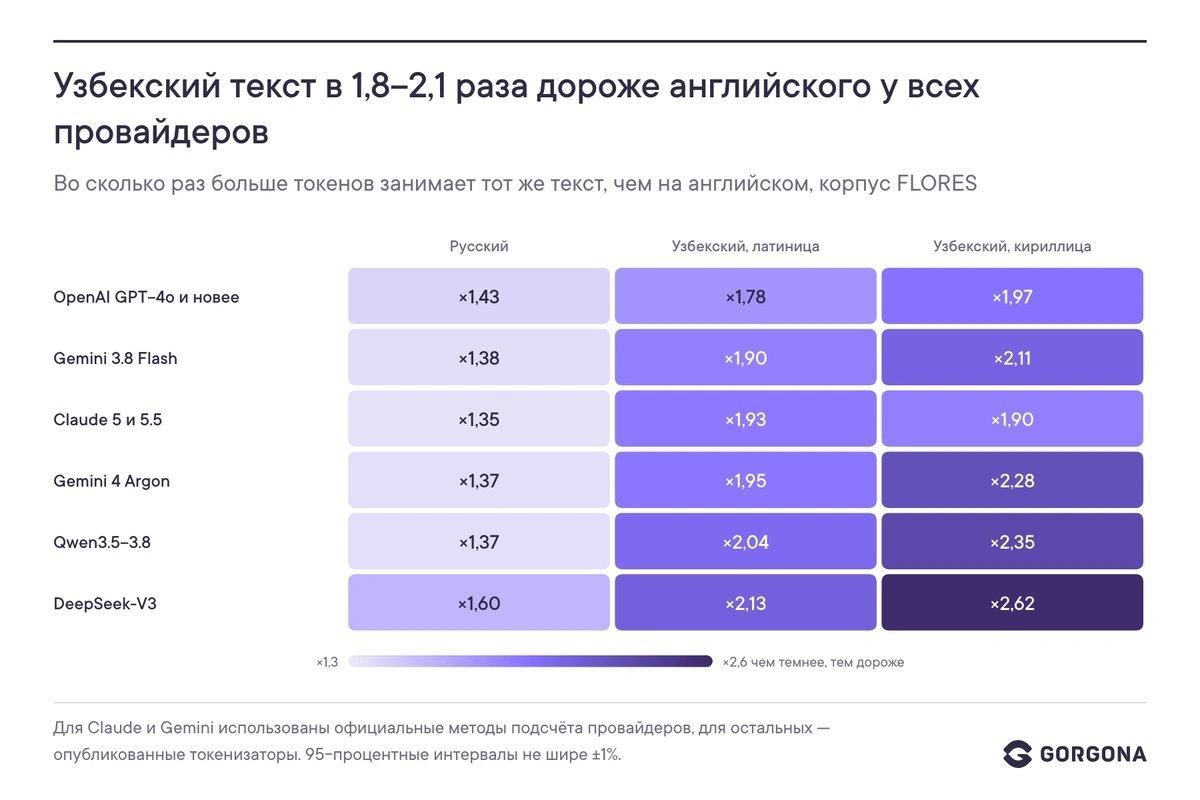
Во сколько раз больше токенов занимает тот же текст, чем на английском. Корпус FLORES: вики-статьи и путеводители.
Результат: узбекский текст на латинице занимает в 1,55−2,17 раза больше токенов, чем на английском, у всех пяти провайдеров: OpenAI, Anthropic, Google, Qwen и DeepSeek. По сравнению с русским он дороже в 1,24−1,54 раза. Ближе к нижней границе оказываются тексты, изначально написанные по-узбекски, ближе к верхней переводы с английского.
Одинаковый прайс, разный счет
Самое неожиданное открытие касается сравнения моделей. Claude Opus 5.5 и GPT-5.6 Sol стоят одинаково за миллион токенов. Но обработать один и тот же узбекский текст на Claude в 1,7 раза дороже: его токенизатор режет текст на большее число частей. Для объема, который на английском занимает миллион слов, это $14,78 против $8,70 только на входе.
Ответы дорожают вслед за запросами. Видимый ответ на узбекском в 1,7−1,8 раза дороже английского, хотя по числу символов ответы почти одинаковы. А Claude Haiku 5.5 без специальной настройки на узбекском чаще включала скрытые рассуждения, которые пользователь не видит, но которые оплачиваются. С ними счет за ответ вырастал в 2,1−2,3 раза.
Отсюда главный практический вывод: модели нужно сравнивать по итоговой стоимости своего текста, а не по цене за токен.
А что с алфавитом
Узбекский пишут двумя алфавитами, и соотношение между ними зависит от модели. У Claude кириллица и латиница стоят одинаково, у других провайдеров разница составляет 7−23%. Дело не в устройстве кириллицы, а в том, сколько текстов в каждой записи модели видели при обучении.
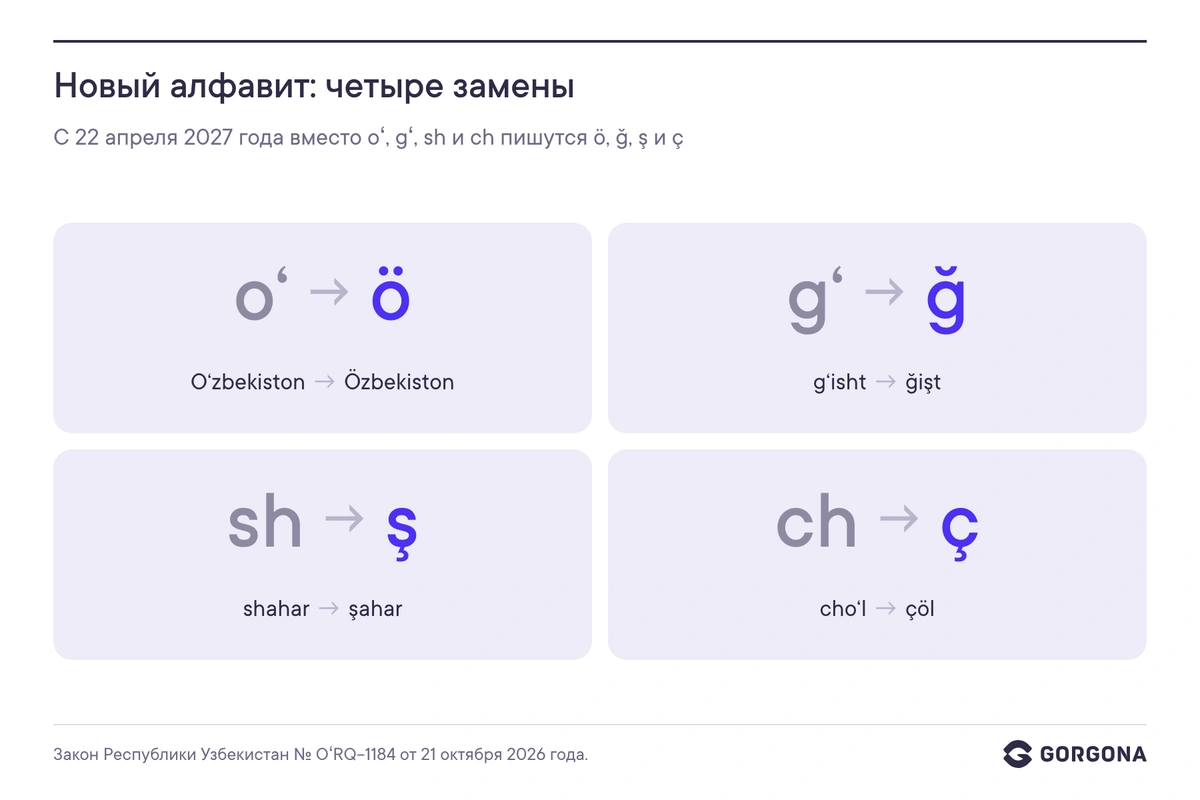
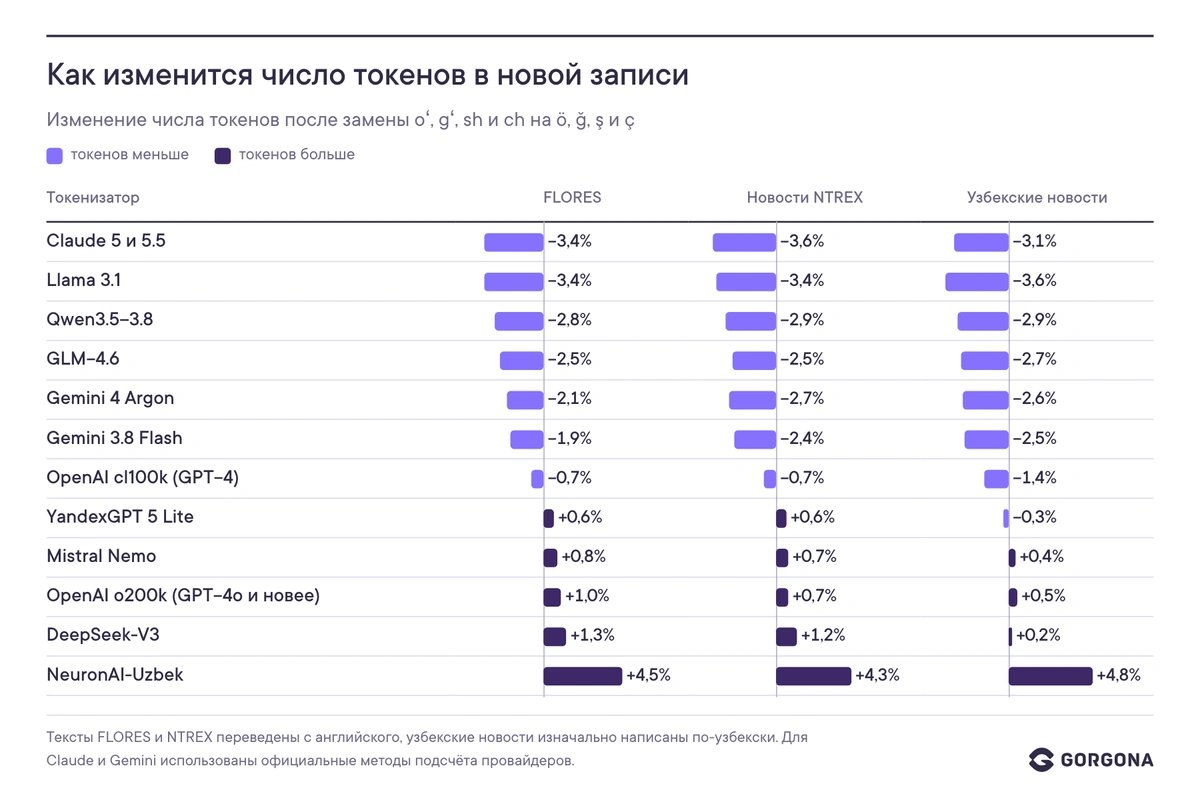
Хорошая новость касается нового алфавита, который вступит в силу 22 апреля 2027 года. Переход не потребует дополнительных расходов на ИИ: у Claude, Gemini и Qwen текст в новой записи занимает на 2−4% меньше токенов, у OpenAI и DeepSeek число токенов практически не меняется. А еще уйдет путаница с апострофом в oʻ и gʻ, который сейчас набирают четырьмя разными символами. Один только выбор символа меняет число токенов до 5%.
Что делать командам
Надбавку за узбекский нельзя отменить настройкой, но ее можно учесть и уменьшить:
- закладывать надбавку в бюджет, если юнит-экономику считали на английских или русских тестах;
- сравнивать модели на своих текстах и считать токены официальными методами провайдера, а не через сторонние сервисы;
- проверить английскую версию системного промпта: он занимает в 1,5−2 раза меньше токенов и оплачивается в каждом запросе, но качество ответов нужно сравнить на своих данных;
- следить за расходом на рассуждения в поле usage и ограничивать их там, где они не нужны;
- при развертывании модели на своих серверах смотреть на словарь токенизатора: словарь, в котором учтен узбекский, почти снимает надбавку.
Почему это важно не только бизнесу
Надбавка за узбекский определяется не числом его носителей, а тем, сколько узбекских текстов видели модели. Поэтому открытые узбекские корпуса работают как цифровая инфраструктура: чем их больше, тем дешевле и, вероятно, качественнее ИИ-сервисы на узбекском для всех, от стартапов до госорганов. Сделать это в одиночку не получится: корпуса, словари и тесты качества под силу только компаниям, университетам и государству вместе.
Полная версия исследования с методикой и данными по каждой модели доступна по ссылке.
На правах рекламы.